Заметки linux администратора
- Details
- Hits: 982
Речь про продукт https://testcontainers.com/. Дошли руки наконец переделать CI с тестами (используют внутри фреймворк testcontainers), testcontainers требует наличия docker daemon, чтобы запускать контейнеры и прогонять тесты. У нас Gitalb имеет раннеры с docker executor, поэтому некоторое время для запуска таких тестов использовался проброс docker.sock внутрь контейнера:
# cat /etc/gitlab-runner/config.toml
...
    [runners.docker]
    volumes = ["/var/run/docker.sock:/var/run/docker.sock", ...
Всем понятно, что это ОЧЕНЬ не безопасно, т.к. дает возможность получить рутовый доступ к машине с раннером из среды CI. Проблему можно сильно уменьшить, если раннер сделать не уровня instance level, а сделать доступным только для определенных реп, где в CI используется testcontainers.
Лучше всего избавится от проброса docker.sock, в качестве варианта решения проблемы приходит на помощь софт podman.
1. ставим podman на линукс сервер
2. ставим доп пакеты - uidmap и passt
3. создаем юзера podman (или любого другого)
4. создаем systemd service:
# systemctl cat podman-api
/etc/systemd/system/podman-api.service
[Install]
WantedBy=multi-user.target

[Service]
Environment="HOME=/home/podman"
ExecStart=podman system service -t 0 unix:///home/podman/podman.sock
Group=podman
Restart=always
StandardError=journal
StandardOutput=journal
Type=simple
User=podman

[Unit]
Description=Run podman sock with podman user rights
systemctl start podman-api
systemdctl enable podman-api
5. В конфиге config.toml раннера меняем:
[runners.docker]
...
  volumes = ["/home/podman/podman.sock:/var/run/docker.sock"
Если всё было сделано верно, то код тестов менять не придется, podman имеет такое же API, что и у docker (бОльшей частью). Из возможных проблем - может понадобиться указать полное имя образов (т.к. в отличие от docker, podman не смотрит по дефолту в регистри docker,io)
Пример логов:
journalctl -f -u podman-api
...
podman[3724210]: time="2026-01-30T11:55:00+03:00" level=warning msg="IdleTracker: StateClosed transition by connection marked un-managed" X-Reference-Id=0xc000011138
podman[3724210]: Trying to pull docker.io/library/mysql:5.7.21...
podman[3724210]: Getting image source signatures
podman[3724210]: Copying blob sha256:38680a9b47a889afdad30e2b778870f30b2adfb670996da71d32fef815446b32
podman[3724210]: Copying blob sha256:c5317a34eddd75b2b48e525137d7d7adc1cbba157fe58eb2fc60bf93b68c7b28
podman[3724210]: Copying blob sha256:4c732aa0eb1bf8ee7a7dfdb2acdb3d1579110241fe47747d2b14a77e2cb504e2
...
podman[3724210]: 2026-01-30 11:55:01.439923525 +0300 MSK m=+287.566402543 image pull  docker.io/library/mysql:5.7.21
podman[3724210]: 2026-01-30 11:55:18.477399695 +0300 MSK m=+304.603878696 volume create 3602b74eea868b243f29019ee4b41f09d63de3afbd10943acc4213668855a68a
podman[3724210]: 2026-01-30 11:55:18.488450879 +0300 MSK m=+304.614929896 container create 7d046192e872cbb695f0086ac2d7ebc246b8523b7f457e4e8782785063cd54a6 (image=docker.io/library/mysql:5.7.21, name=blissful_panini, org.testcontainers=true, org.testcontainers.lang=java, org.testcontainers.version=1.19.1, org.testcontainers.sessionId=XXX)
- Details
- Hits: 781
2025 год выдался богатым на дальнейшее ухудшение связности между РФ и зарубежом (в частности, один небезызвестный хостер в Германии), различные попытки пускать трафик через haproxy через разные ДЦ в других странах не увенчались успехом. Saltstack сервер в РФ не может периодически достучаться до зарубежных минионов, salt-call с них тоже не всегда работает (стейты падают с ошибками File client timed out after 180 seconds и Pillar timed out after 180 seconds). В прошлые года конечно же задумывались о настройке второго солт мастера, который будет близко к удаленным относительно РФ минионам, но т.к. нам нужен обязательно кеш минионов, который хранится на солт мастере (получение информации о другом минионе с миниона через mine.get), то для реализации обязательно этот кеш держать расшаренными между солт мастерами. В солте объявлен для этого функционал - https://docs.saltproject.io/en/latest/topics/cache/index.html, есть нужные модули https://docs.saltproject.io/en/latest/ref/cache/all/index.html#all-salt-cache. В 2025 году они опять были опробованы и все также не работает: был настроен кеш на базе mysql, salt master создал нужную таблицу, наполнил ее данными, но вызов mine.get при этом перестал работать:
salt-call mine.get G@groups:backup groups compound
salt-call mine.get 'groups:salt_master' network.interfaces grain
https://github.com/saltstack/salt/issues/67250 - тут очень похожие симптомы, только у них хранилище на базе редиса.
Как только включаю cache: "localfs", то mine.get начинает работать.
Сейчас пробуем такую схему, которая позволит решить/уменьшить проблему связности:
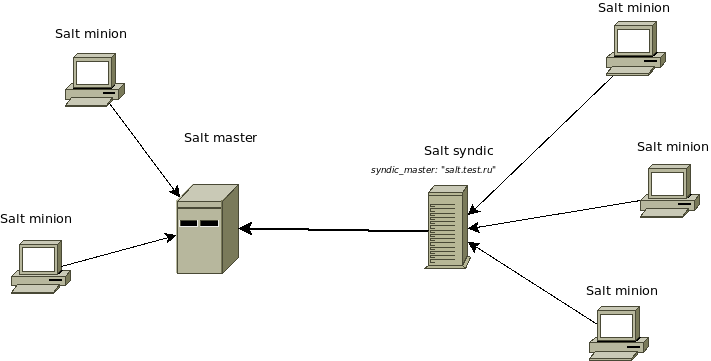
Есть главный salt master в РФ, есть salt master + syndic зарубежом. Ко второму мастеру будут подключены минионы, которые также находятся зарубежом. На обоих солт мастерах стоит cache: "localfs" , чтобы кеш и все нужные файлы синхронизированы, была произведена следующая настройка:
На главном солт мастере:
# systemctl cat sync_files
# /etc/systemd/system/sync_files.service
[Install]
WantedBy=multi-user.target

[Service]
Environment="HOME=/root"
ExecStart=/bin/bash -c 'unison /cache/master/minions ssh://second-master//cache/master/minions -prefer newer && unison /etc/salt/pki/master ssh://second-master//etc/salt/pki/master && unison /code/salt ssh://second-master//code/salt -ignore "Path .git'
Type=oneshot

[Unit]
Description=Executes unison command when a saltstack files has changed
Настройки для unison:
cat /root/.unison/default.prf
# Unison preferences file
auto=true
batch=true
Выше написан systemd сервис, вызывая который будет синхронизировать все нужные файлы - кеш, ключи минионов, код солта (стейты, пиллары и тп). Чтобы не заниматься ручным запуском данного systemd сервиса, можно добавить другой сервис:
systemctl cat salt_monitor.service
[Install]
WantedBy=multi-user.target

[Service]
Environment="HOME=/root"
ExecStart=/bin/bash -c 'inotifywait -q -r -m -e delete,close_write,moved_to,moved_from --exclude /code/salt/.git /code/salt | while read file_changed; do echo "$file_changed changed, running sync_files" && systemctl start sync_files; done'
Restart=always
StandardError=journal
StandardOutput=journal
Type=simple

[Unit]
Description=inotifywait file monitor service
Через inotifywait мониторим изменение файлов в директории с кодом saltstack, если там что-то поменялось, то вызываем сервис синхронизации файлов.
journalctl -f -u salt_monitor.service
journalctl -f -u sync_files
Теперь можно вызывать стейт локально с зарубежного миниона, тогда он подключится ко второму мастеру, работать всё будет быстро. Также можно управлять такими минионами с главного солт мастера через syndic. Решение довольно примитивное и топорное, но если нет ресурсов самостоятельно поправить работу удаленного кеша, то оно вполне может подойти.
- Details
- Hits: 2785
Предположим вы из тех, кто когда-то давно поднял nexus в докер контейнере, поставил дополнительно плагин nexus-repository-composer, долго с этим nexus-ом жил, т.к. постоянно не хватало времени поставить в спринт задачу по его обновлению, да и что скрывать, работал до этого без особых проблем. Из многочисленных репозиториев в наличии у вас есть например пара реп с форматом хранения composer - один с типом hosted и один с типом proxy (https://packagist.org/). Описание проблемы пришло со стороны php разработчиков - обнаружили, что nexus proxy репозиторий для packagist отдает далеко не свежие версии пакетов, связано это с тем, что наш плагин nexus-repository-composer работает со старой версией протокола composer (V1), а это уже считается древним легаси (как мне объяснили пхп разработчики). Долго тянули с обновлением nexus, теперь пробуем разобраться как это всё обновить.
Read more: Обновление старого nexus с orientdb и старым composer плагином до актуальной версии
- Details
- Hits: 2108
Если использовать юниксовые утилиты и какой-нибудь wildcard, под который будет попадать N-ое количество файлов, то они будут периодически падать с такими ошибками:
# ls /home/db/*/*/*.sql
corrupted double-linked list
Aborted
Segmentation fault
Проблема плавающая - можно вызывать команду несколько раз и она может падать, а может и нет.
В нашем случае проблема неожиданно оказалась в snoopy и баге https://github.com/a2o/snoopy/issues/259
2.4.6-5 - версия snoopy в debian 10
2.4.12-1 - версия snoopy в debian 11
В debian 10 таких проблем не было, решением будет просто поставить snoopy из официальных реп
- Details
- Hits: 4345
Довольно часто приходится разбираться с причинами падения linux серверов (здесь сразу оговоримся - речь идет о железных серверах). Обычно что дальше происходит? Запрашиваем remote IP-KVM, немного ждем, подключаемся и пытаемся в маленьком окне консоли разглядеть что же явилось причиной падения (особенно будет "удобно" когда эти логи будут затерты какими-то не существенными записями и что-то понять уже не получится). После перезагрузки можно конечно смотреть логи/дашборды и вполне может быть удастся понять причину падения или хотя бы примерное направление куда копать. Но бывает в логах в момент падения может быть нечто такое:
/var/log/syslog:
@@@@@@@@@@@@@@@@@@@@@@@@@@@@.....@@@@@@@
Некий бинарный мусор, который абсолютно не проясняет причину.
Для решения получения логов перед падением сервера уже давно существует нужное средство - netconsole, топорный модуль ядра, который отправит во вне лог, даже если уже ничего не работает на сервере. Мы до некоторого времени обычно действовали так: сервер начал падать, в IP-KVM не удается найти причину, настраиваем руками netconsole на источнике логов, на каком-то произвольном сервере в tmux-е открываем порт и начинаем ловить сообщения. Но хостер оказался такой, что уровень железного брака довольно высок (догадайтесь с 1-го раза кто :) ), плюс довольно часто некие баги ядра и пришло понимание, что настройку netconsole обязательно нужно настраивать для всех серверов. У всех в инфраструктуре могут использоваться разные Iac, у нас это saltstack, поэтому мы это сделали как-то так (на приемнике не забудьте заранее настроить syslog-ng/other programm). Думаю и для ansible можно сделать нечто подобное. В общем посыл статьи такой - используйте netconsole для разбора причин падений linux сервера, заранее автоматизируйте активацию и настройку модуля на сервере, это значительно ускорит разбор полетов, не потребуется снова ждать когда сервер упадет.
Также может быть оказаться полезной статья https://access.redhat.com/articles/2642741 - с помощью указанных способов можно научиться заранее понимать - штатно или нет произошло выключение сервера. Да, можно мониторить аптайм сервера и если он будет сброшен, то будет алерт в системе мониторинга с письмом в почтовом ящике (как вариант). Но возможен вариант, что сервер был перезагружен штатно, но например в системе мониторинга забыли на время отключить алерты для данного хоста. В общем, это еще один дополнительный вариант мониторинга "правильности" последнего ребута/старта хоста, который вполне может пригодиться.
- Details
- Hits: 7773
Долгое время мы активно использовали только один стек для приема метрик - на базе graphite (carbon-c-relay, carbon-clickhouse, graphite-clickhouse, clickhouse). Что это за стек, можно посмотреть в другой статье (https://linux96.ru/index.php/30-graphite-based-monitoring) и гитхаб страницах проектов. Все бы ничего, но новый софт почти по дефолту выставляет свои метрики в формате для прометея и чтобы получать метрики софта, в наличии есть только экспортеры. Прометей - это почти дефолт в мире мониторинга (как ansible в мире IaC), cнимать метрики хочется, но слазить с graphite стека очень трудно и времязатратно. Что можно придумать?
Read more: Использование Clickhouse как long term storage для Prometheus
- Details
- Hits: 3593
Статья о том, когда есть данные продукты (https://www.saltstack.com/ и https://www.atlassian.com/ru/software/bamboo) в текущей инфраструктуре и захотелось их как-то связать между собой (запускать стейты солта из бамбу). Когда начинаешь гуглить подобный кейс, то каких-то примеров не находишь, а при создании своей реализации хочется сначала изучить чужой опыт, может быть взять что-то за основу (особенно всё печально, если перед этим не было опыта в других CI/CD). В общем, чтобы восполнить данный пробел, опишу как их вместе можно относительно "удобно" состыковать.
- Details
- Hits: 4341
Была мысль написать заметку о настройке modsecurity v3 (https://github.com/SpiderLabs/ModSecurity) в связке с nginx. Есть небольшая книжка как данный софт настраивать, где всё более-менее ясно описано что необходимо сделать, чтобы данная связка заработала. Но жизнь все-таки немного отличается от написанного в книгах. Оказалось, что modsecurity v3 по факту в производственной среде просто не годен (по состоянию на июль 2020 года). Там встретились настолько детские ошибки, что возникает резонный вопрос - как такой софт можно писать? Я не работал с версией 2 (которая глубоко связана с apache2), но версия 3 произвела печальное впечатление. Но обо всем по порядку.