Заметки linux администратора
- Details
- Hits: 5150
Для чего может быть понадобится делать столь странные вещи? Например, одной из причин может быть использование стека приема метрик на базе graphite (т.е. push метрик вместо pull). Это конечно, менее молодежно, чем prometheus, но все равно имеет право на жизнь :). В нашем случае может существовать некий софт, который заточен отдавать свои метрики для prometheus. Мне, в частности, встретился такой на пути - minio (https://github.com/minio/minio). Вот и будем рассматривать на его примере.
Почему просто не поднять prometheus и жить с двумя системами мониторинга? Мой ответ: тогда prometheus надо бекапить(метрики), настраивать свою систему алертинга, в графане использовать еще один datasource. Зачем это делать, если уже все это реализовано в своем стеке? Можно prometheus использовать просто как некий переходник. Для решения данной задачи могут подойти 2 продукта:
- graphite-remote-adapter (https://github.com/criteo/graphite-remote-adapter)
- telegraf - не проверял, но говорят у него можно использовать prometheus как input, а graphite - как output.
- Details
- Hits: 3871
Чтобы восстановить moira из бекапа - нет ничего сложного: берем дамп редиса и переносим на другую машину. Некоторая особенность может быть с тем, что в развернутом бекапе могут отсутствовать настроенные notifications (сами триггеры на месте). Это все из-за security модели moira - https://moira.readthedocs.io/en/latest/installation/security.html и заголовка X-WebAuth-User.
Если виртуальный хост например имел такой вид:
server_name moira.test.ru;
listen 80;

location / {
    proxy_pass http://127.0.0.1:8080;
    proxy_read_timeout 120;
    proxy_set_header Host            moira.test.ru;
    proxy_set_header X-Forwarded-For $remote_addr;
    proxy_set_header X-WEBAUTH-USER  $cwd_user;
    proxy_set_header Authorization   '';
    ...
}
где $cwd_user - это переменная, которая передается при crowd авторизации, соответственно, если в новой moira начнем передавать в данном заголовке другое значение (нет crowd авторизации или предполагается передавать в заголовке X-WEBAUTH-USER всегда одно значение ), то потеряем все настройки notifications и subscriptions. Как же можно восстановить все подписки и уведомления? Достаточно заглянуть в дамп редиса следующим запросом:
redis-cli --scan --pattern 'moira-user-*'
moira-user-subscriptions:test1
moira-user-contacts:test1
moira-user-contacts:test2
moira-user-contacts:test3
moira-user-subscriptions:test2
moira-user-subscriptions:test3
Зная возможные значения moira-user-contacts, можно передавать их значения в заголовке X-WEBAUTH-USER, тем самым восстановить notifications и subscriptions.
- Details
- Hits: 5240
В сети есть некоторое количество информации о том как две указанные вещи можно связать:
https://docs.saltstack.com/en/latest/ref/modules/all/salt.modules.vault.html
https://support.saltstack.com/Third-party_Solutions/HashiCorp/Quick_Guide_to_Vault_Integration
https://medium.com/@aratik711/saltstack-and-vault-integration-20eeb2e7ec9c
https://backbeat.tech/blog/secure-servers-with-saltstack-and-vault-part-2/
Интеграция предполагает множество вариантов, в которых не так-то просто разобраться.
- Details
- Hits: 3781
Речь о проекте https://github.com/moira-alert/moira - системе алертинга для graphite monitoring (как alertmanager у prometheus). Небольшая заметка по advaced trigger: в документации есть совсем немного примеров по их использованию - https://moira.readthedocs.io/en/latest/user_guide/advanced.html. Там приведен один пример и идет отсылка к чтению https://github.com/Knetic/govaluate/blob/master/MANUAL.md для дальнейшего написания таких триггеров. У меня возникло небольшое непонимание по данному синтаксису (как правильно прочитать выражение, которое идет после знака вопроса ?), в моем случае я хотел создать триггер, которые сработает как ERROR, если у сервера №1 или сервера №2 потребляемая память будет больше некоторого порога (42G):
создал 2 таргета:
T1 - stats.berlin.memory.memory.used,
T2 - stats.moscow.memory.memory.used
Триггер:
(t1 > 45097156608 || t2 > 45097156608) ? ERROR:OK
Составил выражение больше по наитию, но спасибо, что в телеграм канале https://t.me/moira_alert быстро подсказали как читать это выражение и как правильнее это загуглить - Тернарная_условная_операция в Си:
Если часть перед знаком вопроса истинна, то результатом вычисления всего выражения будет то, что перед двоеточием. Если ложна, то после двоеточия.
Соответственно, можно таким же образом оперировать всеми 4-мя состояниями метрик у moira - OK, WARN, ERROR, NODATA.
- Details
- Hits: 4049
Может случиться так, что в вашу систему мониторинга на основе graphite + clickhouse попало что-то лишнее/неправильно сформированная метрика или вдруг метрики от приложения/сервера вам стали больше не нужны.
На самом деле многое зависит от схемы именования метрик, если она хорошо спроектирована, то удаление может и не понадобиться. Например, у нас она не очень удачна - все базируется на имени хоста (по-хорошему надо отталкиваться от имени application, которое шлет метрики, например, stats.collectd.my-server1.load):
stats.my-server1
stats.my-server1.load
stats.my-server1.load.midterm
stats.my-server1.load.longterm
stats.my-server1.load.shortterm
stats.my-server1.memory
stats.my-server1.nginx
...
stats.my-server2
stats.my-server2.load
stats.my-server2.load.midterm
...
Read more: Пример удаления ненужных метрик из clickhouse для graphite based monitoring
- Details
- Hits: 10031
Есть 2 подхода для съема метрик - pull (яркий представитель - prometheus) и push (яркий представитель - graphite). Graphite - это мониторинг, состоящий из целой пачки различных микросервисов, некоторые уже почили в бозе, некоторые еще живы. Я по приходу в компанию, где сейчас работаю, застал такую расстановку сил: brubeck (для агрегации метрик), go-carbon ( занимается тем, что принимает метрики от всех и отдаёт их carbonapi), carbonapi (демон отдаёт метрики клиентам (в частности grafana)).
- Details
- Hits: 6367
Предполагается, что читающий знаком с saltstack (https://www.saltstack.com/), писал для него стейты, подключал пиллары или еще чего-нибудь). В этой заметке попробуем реализовать свой state через cmd.run - он будет изменять данные только в случае необходимости плюс покажет нам, что он будет менять в режиме test=true.
- Details
- Hits: 3798
Есть стандартная схема для работы нескольких сайтов
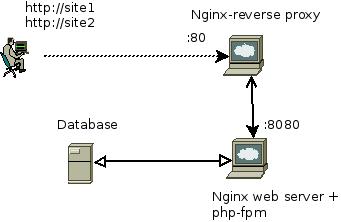
Начальные данные:
- Site1 открывается приемлемое время, Site2 - долго (4-5 сек).
- В браузере задержка открытия проблемного сайта связана с высоким Waiting TTFB
- Site1 и Site2 запущены на одинаковых движках CMS (wordpress),
- Site1 и Site2 уже имеют готовый контент
- Трафик на оба сайта отсутствует
Read more: Частный пример troubleshooting медленного открытия веб-страниц